Lezione 02 di Programmazione 1, 11 settembre 2026. Slide: 1.2 Architettura del calcolatore, slide 1-51. Prima: Introduzione al corso e algoritmi. Dopo: Il Linguaggio C.
Il filo della lezione:
tipi di calcolatore      mainframe, PC, laptop, smartphone
        |
        v
livelli software         hardware -> SO -> software di sistema -> applicativo
        |
        v
Von Neumann              CPU, memoria centrale, memoria di massa, periferiche, tutti sul bus
        |
        v
dentro la CPU            registri, ALU, unità di controllo, clock
        |
        v
ciclo di esecuzione      fetch -> decode -> execute, un'istruzione alla volta
        |
        v
esempio  c <- a + b      leggere e scrivere una cella passando dal bus
        |
        v
memorie e periferiche gerarchia, HDD/SSD, polling e interrupt1Definizioni
Macchina di Von Neumann (slide 10-11). È il nome dell’architettura hardware dei calcolatori: CPU, memoria centrale, memoria di massa e periferiche, collegate dal bus di sistema. Dati e istruzioni stanno nella stessa memoria.
Registro. Una piccola memoria dentro la CPU, grande una parola, velocissima. La CPU lavora solo su dati che stanno nei registri: quello che è in memoria va prima portato lì.
Parola (word) e cella (slide 17). La memoria centrale è una sequenza di celle, ognuna contiene una parola. La lunghezza della parola in bit dipende dalla macchina: 16 bit per l’80286, 32 per Pentium e PowerPC, 64 per UltraSPARC.
Indirizzo e spazio di indirizzamento (slide 18). L’indirizzo è il numero che identifica una cella. Il numero di bit di un indirizzo è caratteristico del processore (Pentium: 32 bit) e ne fissa lo spazio di indirizzamento: con bit si distinguono celle.
RAM (slide 19-20). Random Access Memory, memoria ad accesso casuale: il tempo di accesso non dipende dall’indirizzo della cella. È volatile: il contenuto si perde quando manca l’alimentazione.
ROM. Read Only Memory, memoria a sola lettura. Sulla slide della memoria centrale c’è solo l’etichetta “RAM e ROM” (slide 22), ma all’esame è uscita come domanda. Il contenuto è scritto in fabbrica (o con procedure speciali) e non si perde allo spegnimento. Contiene il programma che parte all’accensione (firmware, il BIOS o UEFI dei PC): quando si accende il calcolatore la RAM è vuota, e qualcuno deve dire alla CPU da dove cominciare.
Memoria di massa (slide 35). Dispositivo di memorizzazione permanente (non volatile) con grande capacità: dischi, SSD, nastri, CD, DVD.
Cache (slide 33). Memoria veloce (SRAM) fra CPU e memoria centrale, che contiene pochi dati acceduti frequentemente.
Bus di sistema (slide 41). Interconnette i componenti del calcolatore. In ogni istante collega due unità, una che trasmette e una che riceve. È diviso in bus dati, bus indirizzi e linee di controllo.
Clock (slide 13). L’orologio interno che genera gli impulsi che scandiscono il lavoro della CPU. La frequenza si misura in hertz, ciclo al secondo.
Polling e interrupt (slide 46). I due modi di sincronizzare CPU e periferiche. Con il polling (a controllo di programma) il processore continua a verificare se il dato è arrivato. Con l’interrupt il processore viene notificato dell’arrivo del dato, e la notifica interrompe quello che stava facendo.
2Concetti
2.1Tipologie di calcolatori
(slide 3-7)
| Tipo | Caratteristiche |
|---|---|
| Mainframe | grandi dimensioni, elevata potenza, tanta memoria. Negli anni ‘70 occupavano stanze fino a 1000 m², oggi lo spazio di un grande frigorifero in un data center. Gestiscono enormi quantità di transazioni in tempo reale: banche, borsa |
| Personal computer (desktop) | monitor e tastiera separati dall’unità centrale, memorie di massa interne o esterne |
| Laptop | versione portatile del PC |
| Handheld (smartphone) | dimensioni limitate |
| Smartwatch | ancora più piccoli |
Sui mainframe la slide cita il CEO di IBM (luglio 2026, WSJ): il 70% in valore di tutte le transazioni finanziarie passa ogni giorno da un mainframe. Restano competitivi rispetto ai sistemi distribuiti e al cloud.
La legge di Moore descrive la miniaturizzazione: il numero di transistor su un chip raddoppia circa ogni due anni. Il grafico della slide 5 mostra il volume dei calcolatori che cala dal mainframe allo smartphone, quello della slide 6 i transistor per chip che salgono da circa a circa fra il 1970 e il 2016. Accanto ai dispositivi sempre più piccoli crescono anche le grandi infrastrutture di calcolo, per esempio quelle per l’intelligenza artificiale.
2.2Organizzazione software
(slide 8, ripresa a slide 36)
Un calcolatore si guarda a strati. Ogni strato usa quello sotto e offre qualcosa di più comodo a quello sopra: salendo, aumenta il livello di astrazione.
+-----------------------------+
|  software applicativo       |   fogli elettronici, client di posta, browser
+-----------------------------+
|  software di sistema        |   ambienti di programmazione: compilatore, debugger
+-----------------------------+
|  sistema operativo          |   Windows, Linux, macOS: gestisce memoria, CPU, periferiche
+-----------------------------+
|  hardware                   |   CPU, memorie, periferiche: la parte fisica che calcola
+-----------------------------+
Chi scrive un programma in C lavora col software di sistema (il compilatore), che produce codice eseguito grazie al sistema operativo sull’hardware. Il passaggio dal sorgente all’eseguibile è in Il Linguaggio C.
Esempio 1: aprire un file PDF. Il lettore PDF (applicativo) chiede al sistema operativo di leggere il file; il SO comanda il disco (hardware) e consegna i byte al lettore. Il lettore non sa niente di tracce e settori.
Esempio 2: compilare con gcc. gcc è software di sistema: prende il sorgente C e produce un eseguibile, che poi il SO carica in memoria centrale e fa eseguire alla CPU.
2.3La macchina di Von Neumann
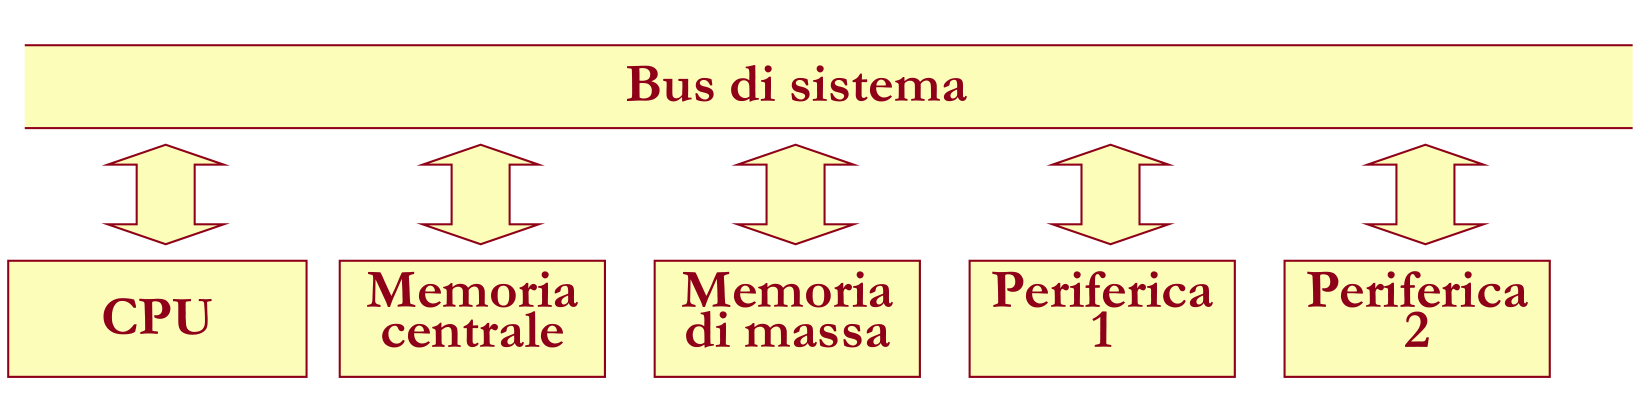
| Componente | Ruolo |
|---|---|
| CPU | svolge l’elaborazione, cioè esegue i programmi |
| Memoria centrale | contiene dati e istruzioni dei programmi in esecuzione |
| Memoria di massa | conserva grandi quantità di dati e programmi in modo persistente (non volatile, a differenza della RAM) |
| Periferiche | tastiere, monitor, schede di rete, stampanti, … |
| Bus di sistema | collega tutti gli altri componenti e permette lo scambio di dati |
L’idea chiave è che dati e istruzioni stanno nella stessa memoria. Un programma è anch’esso una sequenza di parole in memoria, che la CPU va a leggere una alla volta.
Come funziona (slide 14):
- i dati passano da un componente all’altro sempre attraverso il bus di sistema;
- le fasi di elaborazione avanzano in modo sincrono con un orologio di sistema, il clock;
- in ogni intervallo di tempo l’unità di controllo (parte della CPU) stabilisce quale operazione svolgere;
- la macchina lavora in modo sequenziale, un’istruzione dopo l’altra. Le architetture più evolute eseguono anche istruzioni in parallelo.
2.4La CPU
La CPU (Central Processing Unit) è l’unità di elaborazione. Esegue tre passi di un algoritmo (slide 12): carica dalla memoria centrale l’istruzione da eseguire, la interpreta, la esegue (un calcolo numerico, o un trasferimento di informazione, per esempio da memoria a periferica). Dentro ci sono (slide 23-24):
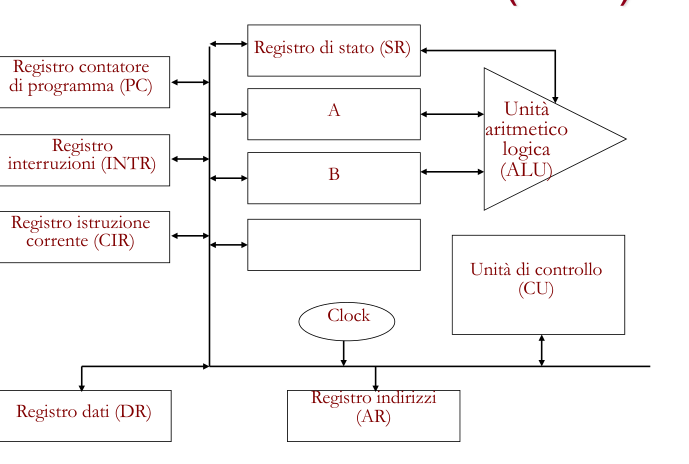
| Parte | Sigla | A cosa serve |
|---|---|---|
| Registro contatore di programma | PC | indirizzo della prossima istruzione da eseguire |
| Registro istruzione corrente | CIR | l’istruzione in elaborazione in questo momento |
| Registro di stato | SR | i flag sull’esito dell’ultima operazione: riporto (C), zero (Z), segno (S), overflow (V) |
| Registri A e B | gli operandi su cui lavora l’ALU | |
| Registri generali | dati temporanei (il riquadro senza nome della slide) | |
| Registro interruzioni | INTR | segnala le richieste di interrupt dalle periferiche |
| Registro indirizzi | AR | l’indirizzo della cella di memoria da leggere o scrivere |
| Registro dati | DR | la parola appena letta dalla memoria, o da scrivere |
| Unità aritmetico-logica | ALU | fa i calcoli: somme, confronti, operazioni logiche |
| Unità di controllo | CU | coordina tutto: prelievo, decodifica, esecuzione |
| Clock | dà il ritmo (sincronizzazione) |
Un modo per ricordarli: AR e DR sono la “porta” della CPU verso il bus (uno dice dove, l’altro porta cosa); PC e CIR servono a sapere quale istruzione si sta facendo (la prossima e quella di adesso); A, B e ALU fanno il conto; SR dice com’è andato.
Esempio di SR: dopo l’ALU dà 0 e accende il flag Z (zero). Dopo il risultato è negativo e si accende S (segno). Le istruzioni di salto condizionato guardano questi flag: un “se ” diventa “sottrai e salta se Z è acceso”.
Clock (slide 13). Il lavoro della CPU è scandito dagli impulsi del clock. Più alta la frequenza, più istruzioni per unità di tempo. Si misura in hertz, ciclo al secondo: nel 1981 si era a MHz, nel 2004 a GHz. La frequenza non è tutto: contano anche la memoria disponibile e altri fattori.
Esempio: a GHz un ciclo dura s ns. A MHz durava s ns, 750 volte di più.
2.5Il ciclo di esecuzione
Per ogni istruzione la CPU ripete tre fasi (slide 26):
All’avvio del programma il PC contiene l’indirizzo della prima istruzione. Poi:
1. Fetch (prelievo).
- La CU copia il contenuto del PC nel registro indirizzi AR.
- La CU manda alla memoria il segnale di controllo READ per leggere la cella all’indirizzo in AR.
- La parola letta arriva nel registro dati DR. La CU aspetta il segnale MFC (memory function completed) che conferma la fine della lettura.
- La CU copia DR nel registro istruzione corrente CIR.
2. Decode (interpretazione). La CU decodifica l’istruzione in CIR: capisce che operazione è e su quali operandi.
3. Execute (esecuzione). La CU genera la sequenza di segnali di controllo che realizza l’istruzione, usando i registri A e B, l’ALU e gli altri registri.
Infine il PC viene incrementato per puntare alla prossima istruzione, e si ricomincia. Nella slide l’incremento è l’ultimo passo; molte CPU reali lo fanno già durante il fetch, e il risultato è lo stesso.
Il fetch è una lettura dalla memoria come le altre: l’unica differenza è che la parola letta finisce nel CIR (è un’istruzione) invece che in A o B (sarebbe un dato). La memoria non sa se sta consegnando un dato o un’istruzione.
Tipi di istruzioni (slide 27):
| Tipo | Esempi |
|---|---|
| aritmetiche | somma, sottrazione, moltiplicazione, divisione, shift |
| di controllo | salto incondizionato o condizionato, chiamata a sottoprogramma |
| di trasferimento dati | da registro a registro, da registro a memoria e viceversa |
Un’istruzione di salto è quella che cambia il PC con un valore diverso da “il successivo”: è così che la CPU realizza i “se” e i “mentre” degli algoritmi.
2.6La memoria centrale
La memoria centrale accoglie dati e programmi su cui opera il calcolatore: mentre usi il computer ci sono il sistema operativo, i programmi aperti e i dati che stai inserendo (slide 16-18).
Struttura. Concettualmente è una sequenza di celle, ognuna delle quali contiene una parola (word).
- A ogni cella si accede direttamente specificandone l’indirizzo, per leggerla o scriverla in un solo passo.
- La lunghezza di una parola, in bit, dipende dalla macchina.
Spazio di indirizzamento. Anche gli indirizzi sono numeri binari di lunghezza fissa. Con indirizzi di bit si possono distinguere celle diverse. Il perché: ognuno dei bit vale 0 o 1, quindi le combinazioni sono , e ogni combinazione è un indirizzo. Con : 000, 001, …, 111, cioè 8 indirizzi, da 0 a 7.
Lo schema della slide 22, con e :
indirizzo (k = 10 bit)         parola (h = 16 bit)
        0   ->  | 0 1 1 0 1 0 0 1 0 0 0 1 1 0 1 0 |
        1   ->  | . . . . . . . . . . . . . . . . |
        2   ->  | . . . . . . . . . . . . . . . . |
      ...
     1023   ->  | . . . . . . . . . . . . . . . . |

spazio di indirizzamento: 2^10 = 1024 celle
La slide 18 dice “ bit”: sono celle (parole), ognuna di bit. La memoria totale è quindi bit: con , sono bit, cioè byte.
Nello schema compaiono anche AR (largo bit, perché contiene un indirizzo) e DR (largo bit, perché contiene una parola), con le frecce load (dalla memoria al DR) e store (dal DR alla memoria).
RAM. La memoria centrale di solito è una RAM:
- ad accesso casuale: il tempo per raggiungere una cella non dipende dal suo indirizzo. Il contrario è un nastro magnetico, dove per arrivare in fondo devi scorrere tutto;
- volatile: spegnendo, il contenuto si perde.
Nelle DRAM (dynamic) il contenuto va rinfrescato periodicamente. Complica la gestione ma rende la singola cella più semplice, quindi si impacchettano più celle nello stesso spazio. Le SRAM (static) non hanno bisogno di refresh ma sono meno dense. Per questo la memoria principale è DRAM (serve tanta) e la cache è SRAM (serve veloce).
ROM. Accanto alla RAM c’è una piccola ROM, non volatile, con il programma di avvio (vedi Definizioni). RAM e ROM sono tutte e due ad accesso casuale: la differenza è che la ROM non si scrive durante il normale funzionamento e non si cancella allo spegnimento.
2.7Unità di misura della memoria
Le slide usano bit, byte, KB e MB senza definirli; all’esame è uscita “unità di memorizzazione”.
| Unità | Quanto vale |
|---|---|
| bit | una cifra binaria, 0 o 1: l’informazione minima |
| byte | 8 bit |
| KB (kilobyte) | byte |
| MB (megabyte) | byte |
| GB (gigabyte) | byte |
Le slide usano la convenzione binaria (1 KB = 1024 byte), come si vede dai conti della slide 33. Per non confondersi con i multipli decimali (1 kB = 1000 byte, usati per esempio da chi vende dischi) i multipli binari si scrivono anche KiB, MiB, GiB.
Esempio 1, i conti della slide 33:
- 1 registro = 8 byte = bit;
- 250 KB byte byte, per 8: bit, come sulla slide;
- 32 MB byte byte, per 8: bit. La slide scrive : è un errore di battitura, la cifra delle decine è 5 e non 4.
Esempio 2, la memoria della slide 42: 64 MB byte, e bit, come scritto nel disegno. Se ogni byte ha il suo indirizzo, servono indirizzi di 26 bit.
2.8Esempio: eseguire
Un’istruzione di alto livello diventa un piccolo algoritmo per la CPU (slide 28-32):
- leggi i valori di e dalla memoria;
- sommali con l’ALU (gli operandi passano dai registri A e B);
- scrivi il risultato nella cella di .
I passi dettagliati della lettura e della scrittura, con i valori delle slide, sono sotto in Esempi svolti a lezione. Il nome non esiste per la CPU: esiste solo l’indirizzo . Associare nomi a indirizzi è il lavoro del compilatore, ed è da qui che nasce il concetto di variabile in Il Linguaggio C.
2.9Il bus di sistema
Il bus collega i componenti del calcolatore (slide 41-42). In ogni istante collega due unità, una che trasmette e una che riceve. È la CPU a scegliere quale collegamento attivare e quale operazione fare (bus mastering, schema master/slave).
Il bus è diviso in tre gruppi di linee:
| Linee | Trasportano |
|---|---|
| bus indirizzi | l’indirizzo della cella o del dispositivo coinvolto |
| bus dati | il dato da leggere o scrivere |
| bus di controllo | che operazione fare (READ, WRITE) e la temporizzazione (OK, MFC) |
Il disegno della slide 42 mostra processore, memoria, hard disk, scheda video (framebuffer), scheda audio e un controller per mouse, tastiera e porta seriale, tutti attaccati alle stesse tre linee: address, data, control. Per questo serve il bus mastering: se due unità trasmettessero insieme sulle stesse linee i segnali si mescolerebbero.
Come ricordarlo: per ogni trasferimento servono tre informazioni, dove (indirizzi), cosa (dati), che cosa fare e quando (controllo).
2.10Gerarchia di memoria
Memorie veloci costano di più e sono piccole, memorie capienti sono lente. Si usano tutte insieme, ognuna al suo livello (slide 33):
       velocità ↑              capacità ↓
  +---------------------+
  |  registri           |   dentro la CPU, pochi byte (es. 64 bit)
  +---------------------+
  |  cache (SRAM)       |   pochi dati usati spessissimo (es. 250 KB)
  +---------------------+
  |  memoria principale |   DRAM, molti più dati, meno veloce (es. 32 MB)
  +---------------------+
  |  memoria di massa   |   HDD, SSD, CD, DVD: tantissimi dati, molto più lenta
  +---------------------+
       velocità ↓              capacità ↑
Gli SSD, dice la slide, sono 4-10 volte più veloci degli HDD in scrittura.
Perché la cache funziona, anche se è piccola: i programmi riusano spesso gli stessi dati e le stesse istruzioni (un ciclo ripete le stesse righe e legge la stessa variabile a ogni giro), e usano spesso celle vicine fra loro. Tenendo vicino alla CPU quei pochi dati, la maggior parte delle letture si risolve in cache senza andare in DRAM. Questo pezzo non è sulle slide.
Le slide fanno anche il parallelo con la memoria umana (slide 34): a lungo termine (si scrive, si legge, si cancella) e a breve termine (volatile, capacità limitata, decade in centinaia di millisecondi; capire una parola stampata richiede circa 150 ms). Il chunking, cioè raggruppare gli elementi in blocchi, ne aumenta la capacità: 3471298056 sono dieci cifre difficili da tenere a mente, 347 129 8056 sono tre blocchi. La slide indica un esercizio in aula, senza testo.
2.11Memorie di massa
Una memoria di massa è un dispositivo di memorizzazione permanente con grande capacità (slide 35). Si classificano in:
- fisse o rimovibili;
- ad accesso sequenziale (nastro) o casuale (disco);
- in sola lettura (RO), lettura e scrittura (RW), o WORM (write once, read many);
- magnetiche, ottiche, magneto-ottiche.
Dimensioni tipiche secondo la slide: floppy 1,44 MB, CD 650 MB, DVD 4,7-18 GB, nastri da 350 MB a oltre 20 GB, hard disk molto più di 150 GB.
Hard disk (HDD) (slide 37-39). Dal 1956. Usa materiali ferromagnetici: ogni micro-cella si magnetizza in una direzione o nell’altra, e ogni direzione vale un bit. La magnetizzazione è semipermanente: resta senza alimentazione ma si può cambiare.
- Lo schema di memorizzazione si crea con la formattazione di basso livello. Ogni superficie è divisa in tracce concentriche, dentro una traccia i dati sono in sequenza, e ogni traccia è divisa in settori. Le tracce alla stessa distanza dal centro sulle diverse facce formano un cilindro.
- Tempo di accesso :
| Tempo | Cos’è | Ordine di grandezza |
|---|---|---|
| ST posizionamento (seek) | spostare la testina sulla traccia giusta | 4-8 ms |
| LT latenza (rotazione) | aspettare che il settore passi sotto la testina | in media mezzo giro: circa 4,2 ms a 7200 giri/min |
| TT trasferimento | portare i dati in memoria | trascurabile (80-110 MB/s) |
Da dove viene il 4,2: a 7200 giri al minuto il disco fa giri al secondo, quindi un giro dura s ms. Quando la testina arriva sulla traccia, il settore cercato può essere appena passato (bisogna aspettare quasi un giro intero) o essere proprio lì (zero attesa): in media si aspetta mezzo giro, ms. Gli 8 ms sono il caso peggiore, non la latenza tipica. La slide scrive “~8 ms a 7200 rpm”: è il tempo di un giro intero.
Perché TT è trascurabile: un blocco di 4 KB byte a 100 MB/s richiede s ms, cento volte meno di ST e LT.
SSD (slide 40). Memorie a stato solido: accesso tutto elettronico, niente parti in movimento. Avvio immediato, posizionamento circa ms, latenza bassissima, - MB/s. Costano di più per GB.
2.12Periferiche
Interfaccia (slide 43-45). Ogni periferica si collega al bus attraverso un’interfaccia di I/O che gestisce lo scambio di dati con la CPU. Lo schema della slide 43: dal bus arrivano le tre linee; nell’interfaccia un decodificatore degli indirizzi (riconosce quando il bus parla con questa periferica), i circuiti di controllo, i registri dei dati e di stato; sotto, la periferica. In generale l’interfaccia contiene un registro dati, un registro di comando e un registro di stato (a volte collegato al registro interruzioni della CPU). I registri della periferica possono:
- stare nello stesso spazio di indirizzi della memoria (memory mapped I/O);
- avere uno spazio di indirizzi e istruzioni separato (port mapped I/O).
Invece di un’interfaccia diversa per ogni dispositivo si usano interfacce standard: seriale RS-232-C, SCSI, USB.
Polling e interrupt (slide 46-48). La CPU è molto più veloce di qualsiasi periferica, quindi bisogna sincronizzarle. Esempio: leggere da un disco.
POLLING                                    INTERRUPT
CPU: comando di lettura                    CPU: comando di lettura
CPU: controlla stato -> non pronto         CPU: continua a fare altro
CPU: controlla stato -> non pronto         ...
CPU: controlla stato -> non pronto         periferica: "pronto!" (interrupt)
CPU: controlla stato -> pronto             CPU: salva il suo stato
CPU: copia il dato in memoria              CPU: routine di gestione (parte del SO)
                                                copia il dato in memoria
CPU: riprende da dove era| Polling | Interrupt | |
|---|---|---|
| come | la CPU chiede in continuazione se il dato è pronto | la periferica avvisa la CPU quando è pronto |
| pro | semplice | la CPU non spreca tempo ad aspettare |
| contro | la CPU resta bloccata in un ciclo di attesa | serve salvare e ripristinare lo stato |
Un’analogia: aspettare un pacco. Polling è scendere ad aprire il portone ogni cinque minuti per vedere se il corriere è arrivato. Interrupt è fare altro finché suona il campanello.
Terminali e stampanti (slide 49-50). Un terminale è tastiera, video e spesso mouse; nei PC sono integrati nel calcolatore. Un video si descrive con dimensione (diagonale in pollici), risoluzione (pixel × pixel), dot pitch (mm) e frequenza di refresh (Hz). Una stampante con velocità (pagine al minuto, PPM) e risoluzione (punti per pollice, DPI); tipi: a margherita (solo testo), ad aghi, a getto d’inchiostro, laser.
3Metodo
Domanda a parole (“descrivi il bus di sistema”, “differenza fra memoria centrale e di massa”). Definizione in una frase, poi le parti o le proprietà in elenco, poi un esempio o un numero. Per il bus: cosa collega, due unità per volta con la CPU master, le tre linee con cosa porta ciascuna, un trasferimento d’esempio.
Lettura o scrittura di una cella. Si scrive sempre nello stesso ordine: indirizzo in AR e sul bus indirizzi; per la scrittura dato in DR e sul bus dati; segnale READ o WRITE sul bus di controllo; per la lettura dato dalla memoria al bus dati e in DR; OK dalla memoria. Per ogni passo si nomina il registro e la linea del bus.
Tracing del ciclo di esecuzione. Tabella con colonne PC, AR, DR, CIR, A, B (e le celle di memoria che cambiano). Per ogni istruzione: le quattro righe del fetch, una riga di decode, le righe dell’execute, l’incremento del PC.
Conti sulla memoria.
- Celle indirizzabili con bit: .
- Bit di indirizzo per celle: il più piccolo con .
- Dimensione totale: celle per bit di una parola, poi diviso 8 per i byte.
- Controllo: le potenze di 2 da sapere a memoria, , , , , .
Tempo di accesso di un disco.
- Giri al secondo giri al minuto .
- Durata di un giro giri al secondo, in ms.
- Latenza media mezzo giro.
- Tempo di accesso , con TT di solito trascurabile.
4Esempi svolti a lezione
Leggere il valore di (slide 30). Nell’esempio delle slide sta nella cella di indirizzo e vale .
- La CU carica l’indirizzo nel registro AR, che lo mette sul bus indirizzi.
- La CU manda READ sul bus di controllo.
- La memoria mette il contenuto della cella , cioè , sul bus dati, e il valore arriva nel registro DR.
- La memoria risponde OK sul bus di controllo: la lettura è completata.
| passo | AR | DR | bus indirizzi | bus dati | bus controllo |
|---|---|---|---|---|---|
| 1 | 123 | 123 | |||
| 2 | 123 | 123 | READ | ||
| 3 | 123 | 42 | 123 | 42 | |
| 4 | 123 | 42 | OK |
Poi 42 passa da DR al registro A, pronto per la somma. Lo stesso per , che finisce in B.
Scrivere il risultato in (slide 32). Simmetrico: la CU mette l’indirizzo di ( nelle slide) in AR e sul bus indirizzi, mette il risultato () in DR e sul bus dati, manda WRITE sul bus di controllo, la memoria salva il valore nella cella e risponde OK. La slide numera cinque passi:
| passo | AR | DR | bus indirizzi | bus dati | bus controllo | cella 321 |
|---|---|---|---|---|---|---|
| 1 | 321 | 321 | ? | |||
| 2 | 321 | 70 | 321 | 70 | ? | |
| 3 | 321 | 70 | 321 | 70 | WRITE | ? |
| 4 | 321 | 70 | 321 | 70 | 70 | |
| 5 | 321 | 70 | OK | 70 |
La differenza con la lettura: qui il dato va da DR alla memoria, e DR si riempie prima del segnale; nella lettura DR si riempie dopo. Con e , nelle slide vale .
Il ciclo completo su un programmino (esempio in più, non sulle slide: la slide 26 descrive le fasi ma non le segue su un programma). Una macchina giocattolo con quattro istruzioni in memoria, che fa proprio con i valori delle slide:
indirizzo   contenuto
    4       LOAD A, 123      A ← cella 123
    5       LOAD B, 124      B ← cella 124
    6       ADD              A ← A + B  (con l'ALU)
    7       STORE A, 321     cella 321 ← A
  ...
  123       42               a
  124       28               b
  321       ?                c
All’inizio il PC vale 4.
| fase | PC | AR | DR | CIR | A | B | cella 321 |
|---|---|---|---|---|---|---|---|
| fetch 1: PC → AR | 4 | 4 | ? | ||||
| fetch 2-3: READ, la parola arriva in DR | 4 | 4 | LOAD A, 123 | ? | |||
| fetch 4: DR → CIR | 4 | 4 | LOAD A, 123 | LOAD A, 123 | ? | ||
| decode: leggere la cella 123 in A | 4 | 4 | LOAD A, 123 | ? | |||
| execute: 123 → AR, READ, 42 in DR, DR → A | 4 | 123 | 42 | LOAD A, 123 | 42 | ? | |
| PC + 1 | 5 | 123 | 42 | LOAD A, 123 | 42 | ? | |
| fetch dell’istruzione in 5 | 5 | 5 | LOAD B, 124 | LOAD B, 124 | 42 | ? | |
| execute: 124 → AR, READ, 28 in DR, DR → B | 5 | 124 | 28 | LOAD B, 124 | 42 | 28 | ? |
| PC + 1 | 6 | 124 | 28 | LOAD B, 124 | 42 | 28 | ? |
| fetch dell’istruzione in 6 | 6 | 6 | ADD | ADD | 42 | 28 | ? |
| execute: l’ALU somma A e B, risultato in A | 6 | 6 | ADD | ADD | 70 | 28 | ? |
| PC + 1 | 7 | 6 | ADD | ADD | 70 | 28 | ? |
| fetch dell’istruzione in 7 | 7 | 7 | STORE A, 321 | STORE A, 321 | 70 | 28 | ? |
| execute: 321 → AR, A → DR, WRITE | 7 | 321 | 70 | STORE A, 321 | 70 | 28 | 70 |
| PC + 1 | 8 | 321 | 70 | STORE A, 321 | 70 | 28 | 70 |
Controllo: , ed è il valore che le slide scrivono nella cella 321. Si contano quattro istruzioni e sette accessi alla memoria: quattro fetch, due letture di dati, una scrittura. Ogni accesso passa dal bus, ed è uno dei motivi per cui una frequenza di clock non è un numero di istruzioni al secondo.
La memoria della slide 22. bit di indirizzo, bit di parola: celle, indirizzi da 0 a 1023, in tutto bit byte KB.
Le dimensioni della slide 33 e la memoria della slide 42: svolte sopra in Unità di misura della memoria, compreso l’errore di battitura sui 32 MB.
Latenza a 7200 giri al minuto (slide 39): svolta sopra, 4,2 ms in media, 8,3 ms nel caso peggiore.
Lettura da disco a polling e a interrupt (slide 47-48): lo schema a due colonne sopra. Nei passi della slide, a polling: (1) la CPU manda il comando di lettura e si mette in attesa; (2) durante l’attesa esegue un ciclo che controlla il registro di stato della periferica; (3) appena il dato è pronto lo copia dal registro dati della periferica in un suo registro e da lì in memoria. A interrupt: (1) la CPU manda il comando e prosegue; (2) quando il dato è pronto la periferica solleva un interrupt; (3) la CPU interrompe quello che fa, salva il suo stato ed esegue la routine di gestione delle interruzioni (parte del SO); (4) la routine copia il dato dal registro della periferica in un registro della CPU e poi in memoria; (5) la CPU riprende da dove era.
5Esercizi tipo esame
In una pagina a parte, dal più facile al livello del 30: Architettura hardware e software di un calcolatore (esercizi).
6Errori tipici
- Confondere PC (un indirizzo) e CIR (un’istruzione).
- Dire che con bit si indirizzano bit: sono celle, ognuna di una parola (la slide lo scrive male).
- Prendere la frequenza di clock per il numero di istruzioni al secondo.
- Usare un giro intero come latenza media di un disco: è mezzo giro.
- Confondere “accesso casuale” con “accesso a caso”: vuol dire che ogni cella si raggiunge direttamente, nello stesso tempo.
- Scambiare polling e interrupt.
- Dire che la ROM non è ad accesso casuale: lo è, come la RAM. La differenza è volatile e scrivibile contro non volatile e a sola lettura.
- Confondere bit e byte nei conti (un fattore 8), o 1000 e 1024.
- Nel descrivere una scrittura, mettere il dato sul bus indirizzi o l’indirizzo in DR.
- Mettere la cache nella memoria di massa: è fra registri e memoria principale, ed è SRAM.
7Domande
Quali sono i quattro livelli dell’organizzazione software di un calcolatore, dal basso verso l’alto?
Dal basso: hardware, sistema operativo, software di sistema (compilatore, debugger), software applicativo. Salendo aumenta il livello di astrazione.
Quali componenti ha la macchina di Von Neumann e cosa li collega?
CPU, memoria centrale, memoria di massa, periferiche, collegati dal bus di sistema.
Cosa contiene il registro PC e cosa il registro CIR?
PC: l’indirizzo della prossima istruzione da eseguire. CIR: l’istruzione in esecuzione, già letta dalla memoria. Il PC contiene un indirizzo, il CIR un’istruzione.
A cosa servono i registri AR e DR?
AR: l’indirizzo della cella da leggere o scrivere, anche quando è un’istruzione. DR: la parola appena letta dalla memoria o quella da scrivere.
Descrivi i passi della fase di fetch.
PC → AR; la CU manda READ alla memoria; la parola letta arriva in DR; la CU aspetta MFC (memory function completed); DR → CIR.
In che unità si misura la frequenza del clock e cosa indica?
In hertz: 1 Hz = un impulso di clock al secondo. Non è il numero di istruzioni al secondo, perché ogni istruzione richiede in generale più cicli di clock (fetch, decode ed execute sono sequenze di passi, e l’accesso alla memoria può far aspettare).
Con indirizzi di bit, quante celle di memoria si possono indirizzare?
celle, ognuna di una parola da bit. Con sono 1024 celle. Le slide scrivono “ bit”: è un errore.
Cosa significa che la RAM è ad accesso casuale? E che è volatile?
Accesso casuale: si raggiunge una cella direttamente dal suo indirizzo, e il tempo non dipende da quale sia (il contrario del nastro). Volatile: senza alimentazione il contenuto si perde.
-
Quali sono le tre linee del bus di sistema e cosa trasporta ciascuna?
-
Descrivi i passi per leggere il valore della variabile che sta all’indirizzo .
-
Da quali tre tempi è composto il tempo di accesso di un hard disk?
-
Che differenza c’è fra gestione delle periferiche a polling e a interrupt?
-
Cos’è la ROM e in cosa differisce dalla RAM?
-
A cosa serve la cache e dove sta nella gerarchia di memoria?
-
Quanti bit sono 1 KB, nella convenzione delle slide?
-
Descrivi i passi per scrivere il valore 70 nella cella 321: quali registri e quali linee del bus?
-
Perché DRAM per la memoria principale e SRAM per la cache?
-
Cosa contiene il registro di stato SR e a cosa servono i suoi flag?
-
Perché la latenza media di un disco è mezzo giro e non un giro intero?
-
Cosa vuol dire bus mastering?